Informācijas plūsmas izpēte no posteromediālās garozas vizuālās telpiskās darba atmiņas laikā: Magnetoencefalogrāfijas pētījums, 2. daļa
Jan 15, 2024
Displeja iekārta un uzstādīšana. Vizuālie stimuli tika prezentēti, izmantojot MATLAB (versija R2014b) un rutīnas no Psychtoolbox (Brainard, 1997; Pelli, 1997; Kleiner et al., 2007).
Vizuālā stimulācija ir ārējā informācija, ko mēs saņemam caur acīm, un tai ir liela ietekme uz mūsu atmiņu. Pētījumi liecina, ka vizuālajai stimulācijai ir liela ietekme uz atmiņu.
Pirmkārt, vizuālā stimulācija var uzlabot atmiņas saglabāšanu un atgūšanu. Kad mēs redzam vizuāli pārsteidzošu attēlu vai attēlu, mūsu smadzenes to saglabā kā specifiskāku atmiņu, un to ir vieglāk atrast, kad mums ir jāatgūst atmiņa. Tas ietver spilgtas krāsas un unikālas formas attēlus.
Otrkārt, vizuālā stimulācija var arī uzlabot atmiņas noturību. Daži pētījumi liecina, ka attēlus vai attēlus atceramies vieglāk nekā vienkāršus vārdus vai skaitļus. Tāpēc, veidojot mācību vai pētniecības materiālus, attēlu apvienošana ar tekstu palīdzēs saglabāt atmiņu.
Visbeidzot, vizuālā stimulācija var arī stimulēt mūsu radošumu un iztēli, kas ir ļoti svarīgi atmiņai. Kad mēs apvienojam savas smadzenes ar vizuālo ievadi, mēs varam radīt jaunas un unikālas atmiņas, kas vieglāk iekļūst mūsu smadzenēs un rosina mūsu iztēli.
Kopumā vizuālajai stimulācijai ir liela ietekme uz atmiņu. Izveidojot vizuāli pārsteidzošus mācību materiālus vai izmantojot citus vizuālās stimulācijas veidus, mēs varam palīdzēt mūsu smadzenēm labāk mācīties un saglabāt zināšanas, kā arī stimulēt mūsu radošumu un iztēli. Var redzēt, ka mums ir jāuzlabo atmiņa, un Cistanche deserticola var ievērojami uzlabot atmiņu, jo Cistanche deserticola ir tradicionāls ķīniešu ārstniecības materiāls, kam ir daudz unikālu efektu, no kuriem viens ir atmiņas uzlabošana. Maltās gaļas iedarbīgumu nodrošina dažādas tajā esošās aktīvās sastāvdaļas, tostarp skābe, polisaharīdi, flavonoīdi utt. Šīs sastāvdaļas var dažādos veidos veicināt smadzeņu veselību.
Noklikšķiniet uz zināt papildinājumus, lai uzlabotu atmiņu
MEG sesiju laikā stimuli tika projicēti caur pielāgotu logu, izmantojot InFocus IN5108 LCD aizmugures projekcijas sistēmu (InFocus), kas atrodas ārpus Faraday vairoga, uz ekrāna, kas atrodas virs dalībnieka, ar displeja platumu 12 grādu redzes leņķī. Dalībnieki, guļot guļus, skatīja ekrānu no 113 cm.
Psihofiziskajam eksperimentam stimuli tika parādīti galddatorā DellOptiPlex 9010 ar AMD Radeon HD 7570 grafisko karti, lai piesaistītu stimulus 60 33 cm Samsung SyncMasterSA950 Full HD 3D LED monitoram, kas atsvaidzināts ar 120 Hz. Eksperimenti notika aptumšotā telpā, un dalībnieki sēdēja un skatījās uz ekrānu no 64 cm attāluma.
Vizuālie stimuli un uzdevums. Psihofizisko un MEG sesiju laikā dalībnieki pabeidza vizuālās telpiskās darba atmiņas uzdevumu. Mēs pamatojām uzdevumu un stimulus uz iepriekš izmantoto darba atmiņas izaicinājuma uzdevumu (Kochan et al., 2010, 2011).
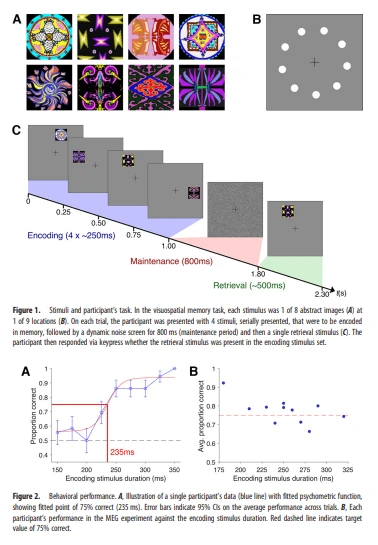
Mūsu uzdevumam mēs izmantojām 8 abstraktos rakstu attēlus, kas tika izmantoti iepriekšējā darbā (1.A att.). Katrs kodēšanas un izguves stimuls ietvēra vienu no šiem 8 attēliem vienā no 9 vietām (1.B att.).
Katrs attēls bija kvadrāts, ar 2,5 grādu vizuālo leņķi diametrā, un katra no 9 vietām bija centrēta pozīcijā 4 grādu vizuālā leņķī no ekrāna centra. Ekrāna centrā vienmēr bija tumši pelēks krusts (sk. 1. att., platums 1 grāds). Visi attēli tika parādīti uz vidēji pelēka fona.
Katrs izmēģinājums sekoja secībai, kas parādīta 1.C attēlā. Kodēšanas laikā secīgi tika parādīti četri stimuli ar tādu pašu ilgumu. Kodēšanas stimuli vienmēr bija četri dažādi attēli četrās dažādās vietās, un dalībniekam bija jāatceras šie četri attēla identitātes un atrašanās vietas savienojumi.
Pēc kodēšanas stimuliem dinamisks baltais troksnis tika parādīts 800 ms (uzturēšanas periods): trokšņa modelis bija 20% kontrasts, centrēts uz vidējo pelēko krāsu, atjaunināts pie 120 Hz.
Apkopes laikā mēs iekļāvām dinamisko troksni, lai samazinātu vizuālos pēcattēlus, ko izraisījuši kodēšanas stimuli. Pēc apkopes perioda tika parādīts izguves stimuls, un dalībnieki norādīja, vai izguves stimuls ir iekļauts kodēšanas stimulu komplektā šim izmēģinājumam.
Pēc atbildes (izmantojot pogas nospiešanu) dalībnieki saņēma atgriezenisko saiti: fiksācijas krustiņš mainījās uz zaļu, ja tie bija pareizi, un sarkanu, ja tie bija nepareizi.
Pēc 200 ms atgriezeniskās saites fiksācijas krusts atgriezās tumši pelēkā krāsā, un pēc mainīga 300–800 ms intervāla (izmēģinājumos nejauši mainījās) sākās nākamais izmēģinājums. Pogas, kas tika izmantotas, lai reaģētu uz mērķa esamību/navēšanu, tika apmainītas katrā blokā.
Dalībnieki pabeidza uzdevumu 72 izmēģinājumu blokos. Lai atvieglotu klasifikatora analīzi, kuras pamatā ir MEG signāli (zemāk), katrā kodēšanas stimulā izmantotie stimuli tika pilnībā līdzsvaroti katrā blokā.

8 attēli 9 vietās radīja 72 unikālus stimulus, un katrā izmēģinājumu blokā šie 72 stimuli tika izmantoti vienu reizi kā pirmais, otrais, trešais un ceturtais kodēšanas stimuls.
Kodēšanas stimulu komplekti tika izvēlēti tā, lai tie vienmēr saturētu četrus dažādus attēlus četrās dažādās vietās bez atkārtotiem attēliem vai vietām. Mēs iepriekš iedalījām pusi no šiem nejauši atlasītiem izmēģinājumiem, lai tie būtu "mērķa klātbūtnes" izmēģinājumi, bet pārējā daļa būtu "mērķa neesamības" izmēģinājumi.
Katram izmēģinājumam mēs izvēlējāmies izguves stimulu atkarībā no tā, vai tas tika apzīmēts kā "mērķa klātbūtnes" izmēģinājums (izguves stimuls bija viens no kodēšanas stimuliem) vai izmēģinājums "mērķa nav" (kodēšanas laikā izguves stimuls netika iekļauts).
Atšķirībā no kodēšanas stimuliem, izguves stimuli ne vienmēr saturēja katru no 72 unikālajiem stimuliem katrā blokā, bet visi attēli un atrašanās vietas tika izmantoti vienādu skaitu reižu visā blokā.
Mēs izmantojām sākotnējo psihofizisko sesiju, lai apmācītu dalībniekus veikt uzdevumu un kalibrētu uzdevuma grūtības atbilstoši viņu sniegumam. Psihofiziskās sesijas laikā kodēšanas un izguves stimulu ilgums dažādos izmēģinājumos bija atšķirīgs.
Katrā izmēģinājumā katram kodēšanas stimulam bija vienāds ilgums, un izguves stimuls bija divreiz ilgāks par šo. Katrā blokā tika izmantots 9 ilguma diapazons. Katrs dalībnieks pabeidza četrus sākotnējos treniņu blokus, kur kodēšanas ilgums bija 150–400 ms.
Mēs izmantojām katra dalībnieka uzvedību pirmajos četros treniņu blokos, lai izvēlētos mazāku ilgumu diapazonu otrajam uzdevumu bloku kopumam. Dati tika izmantoti no šīs otrās četru bloku kopas, lai novērtētu ilgumu, kurā katrs dalībnieks sasniedza 75% pareizu uzdevuma izpildi. Datu paraugi no 1 dalībnieka parādīti 2.A attēlā.
Katram dalībniekam pielāgojiet savus datus ar sigmoidālu funkciju (1. vienādojums), kur pareizā proporcija (P) mainījās atkarībā no kodēšanas ilguma (10) atbilstoši pārtveršanas parametram (a, kas nosaka ilgumu, x, kur p {{2} }.75), slīpuma parametru (b ) un pārtraukuma ātrumu (r) saskaņā ar šādu:

Mēs atradām vispiemērotāko funkciju (parādīta sarkanā krāsā 2.A attēlā), izmantojot MATLAB funkcijuTlingit. Pamatojoties uz šiem psihofizikālajiem datiem, mēs katram dalībniekam MEG sesijai izvēlējāmies vienu kodēšanas stimula ilgumu, lai kopējais sniegums būtu 75% pareizs.
Šis mērķis tika izvēlēts, lai nodrošinātu, ka neviens dalībnieks neveic griestu vai grīdas uzdevumu, un lai uzdevums būtu pietiekami izaicinošs katram dalībniekam, jo Kochan et al. (2011) rezultāti liecina, ka PMC ir īpaši iesaistīts prasīgos vizuālās telpiskās darba atmiņas izaicinājumos.
MEG sesijas laikā katrs dalībnieks pabeidza 8 izmēģinājumu blokus ar šo vienu kodēšanas stimula ilgumu un izguves stimula ilgumu, kas bija divreiz lielāks par šo vērtību. Katram dalībniekam izmantotais ilgums un viņu kopējais sniegums MEG sesijas laikā ir parādīts 2.B attēlā.
MEG un MRI skenēšanas protokoli. MEG dati tika savākti ar visas galvas MEG sistēmu (modelis PQ1160R-N2, KIT) Macquarie Universitātē, kas sastāv no 160 koaksiāliem pirmās kārtas gradiometriem ar 50 mm bāzes līniju (Kadoet al., 1999; Uehara et al., 2003).
Pirms MEG mērījumiem uz dalībnieka galvas tika novietotas piecas marķiera spoles. Marķieru pozīcijas, deguna dobums, kreisie un labie preauricular punkti un dalībnieka galvas forma tika reģistrēti ar pildspalvas digitalizatoru (Polhemus Fastrack), izmantojot vismaz 2000 punktus.
Katra dalībnieka MEG dati tika savākti vienā sesijā 90 minūtes ar paraugu ņemšanas frekvenci 1000 Hz. Katrā izmēģinājumā dalībnieki atbildēja, izmantojot Fiber Optic Response Pad (pašreizējie modeļi).
MRI notika Macquarie universitātes slimnīcā ar 3TSiemens Verio sistēmu. Mēs ieguvām 3D T1-svērtos attēlus, izmantojot MP-RAGE secību (šķēles biezums 1.0 mm, izšķirtspēja 1.0 1.0mm).
MEG datu analīze: avota rekonstrukcija. Automātiskie segmentācijas procesi no Freesurfer 6.{1}} (Dale et al., 1999; Fischl et al., 1999) tika piemēroti katra dalībnieka strukturālajai MR, lai noteiktu viņu pelēkās/baltās vielas un pial/pelēkās vielas robežas.
Prāta vētra (neuroimage.usc.edu/brainstorm, 2019. gada janvāra versija) (Tadel et al., 2011) tika izmantota, lai iepriekš apstrādātu MEG signālus un veiktu avota rekonstrukciju. Mēs importējām anatomiskos attēlus un Freesurfersegmentāciju un definējām galvas modeļus, pamatojoties uz katra dalībnieka spiālo / pelēko robežu (kortikālo virsmu).
Mēs saskaņojām MEG datu kopas ar galvas modeli, saskaņojot anatomiju, pamatojoties uz MRI, ar tajā ierakstītajiem deguna, preauricular punktiem un galvas formas datiem no MEG sesijas. Mēs izveidojām priekšējo modeli katram no 8 izmēģinājumu blokiem, piemērojot vairāku sfēru modeli (Huang et al., 1999) to garozas virsmai izmērītajā galvas vietā bloka laikā.
MEG dati tika iepriekš apstrādāti programmā Brainstorm ar iecirtumu filtrēšanu (50, 100 un 150 Hz), kam sekoja joslas caurlaides filtrēšana (0,2–200 Hz). Sirds un acu mirkšķināšanas artefakti tika noņemti, izmantojot signāla telpas projekciju: sirds un acu mirkšķināšanas notikumi tika identificēti, izmantojot Brainstorm noklusējuma filtrus, manuāli pārbaudīti un pēc tam izmantoti, lai novērtētu nelielu skaitu bāzes funkciju, kas atbilst šiem trokšņa komponentiem, kas tika noņemti no ierakstiem (Uusitalo un Ilmoniemi, 1997).
No šiem funkcionālajiem datiem mēs katram izmēģinājumam ieguvām divus laikmetus: (1) sākotnējās aktivitātes mērījums (100 līdz 1 ms attiecībā pret pirmā kodēšanas stimula sākumu) un (2) izraisītā reakcija (0) –4000 ms). Mēs izmantojām bāzes mērījumus, lai novērtētu trokšņa kovariāciju katram blokam, un pēc tam izsauktajiem datiem piemērojām minimālās normas avota rekonstrukciju.
Katrai avota rekonstrukcijai mēs izmantojām 15,000 virsotnes garozas virsmu (standarta sietu ar atlanta informāciju, kas importēta no Freesurfer segmentācijas). Dipola orientācijas avota modelī tika ierobežotas, lai tās būtu normālas garozas virsmai, trokšņu kovariance tika regulēta, izmantojot vidējo īpašvērtību, un visām pārējām opcijām tika iestatītas to noklusējuma vērtības.
ROI. Mēs definējām četrus ROI: pakauša garozu (OC), centrotemporalcortex (VTC), PMC un PFC, pamatojoties uz atlanta datiem, kas tika saskaņoti ar katra dalībnieka anatomiju Freesurfer segmentācijas procesa laikā. Mēs izmantojām Freesurfer Destrieux atlantu, lai definētu savus ROI (sk. Destrieuxet al., 2010).
Mūsu ROI ietvēra šādas parcelācijas no Destrieux et al. (2010, to 1. tabula): OC ietvēra visu OC (indeksi 2, 11, 19, 20, 22, 42, 44, 51, 57, 58, 59); VTC ietvēra inferiortemporal žiri un sulci (indeksi 37, 72); PMC ietvēra cilpas un rievas vidējo un aizmugurējo daļu, precuneus, cingulāta vagas marginālo zaru un subparietālo vagu (indeksi 8, 30, 46, 71), un PFC ietvēra visu PFC (indeksi 1, 5, 6, 24, 31, 62, 63, 64, 70).
Šie četri ROI ir parādīti uz nepiepūstas garozas virsmas 3. un 4. attēla augšējā labajā stūrī. Visi ROI ietvēra nepārtrauktas garozas virsmas daļas: abas atsevišķās PMC daļas šajās attēlu leģendās tika savienotas vagā. Katram ROI mēs izvilkām MEG datus, kas atbilst 15,000 avotu apakškopai, kas atradās ROI, un izmantojām šīs datu kopas tālāk sniegtajās analīzēs.
Klasifikācijas analīzes. Katram ROI mēs veicām virkni daudzfaktoru modeļu klasifikācijas analīžu katrā 5 ms diapazonā visā izmēģinājuma laikā. Katrā klasifikācijā tika jautāts, cik labi avota datus no viena ROI vienā laika joslā var izmantot, lai atšķirtu divu klašu izmēģinājumus: piemēram, izmēģinājumus ar pirmo kodēšanas stimulu 1. vietā pret 2. vietu.
Mēs apmācījām klasifikatorus (lineāro atbalsta vektoru mašīnu), lai izšķirtu katra stimula atrašanās vietu un attēlu (četri kodēšanas stimuli 1 1 izguves stimuls): 9 vietām tika veikti 36 salīdzinājumi pa pāriem; un 8 attēliem bija 28 pāru salīdzinājumi. Šīm klasifikācijām mēs izveidojām "pseidopārbaudījumus", aprēķinot vidējo rādītāju visiem izmēģinājumiem ar vienādu vērtību interesējošo dimensiju, bet ar atšķirīgām vērtībām visā citā dimensijā.
Pseido-izmēģinājumi vienmēr tika līdzsvaroti starp neatbilstošo interešu dimensiju vienam un tam pašam stimulam. Klasificējot stimula atrašanās vietu pirmajam kodēšanas stimulam, katrs pseido izmēģinājums bija 8 izmēģinājumu vidējais rādītājs, kur pirmais kodēšanas stimuls atradās tajā pašā vietā: viens izmēģinājums katram stimula attēlam. Tāpat pseido-izmēģinājumi stimulu attēlu klasificēšanai tika līdzsvaroti visā šī stimula atrašanās vietā.
Lai nodrošinātu, ka mūsu rezultāti nav atkarīgi no konkrēta izmēģinājumu piešķiršanas pseidopārbaudēm, mēs izveidojām 20 pseidopārbaudījumu kopas katrai pāru klasifikācijai, atjauninot katras kopas izmēģinājumu izlases veida piešķiršanu un vidējo klasifikācijas veiktspēju. Katrā gadījumā mēs apmācījām klasifikatoru, izmantojot 90% datu, un pārbaudījām tā veiktspēju, izmantojot saglabātos datus (10%), lai izvairītos no apļveida.
Mēs atkārtojām šo procesu 10 reizes (10-kārtīga savstarpēja validācija), lai katrs pseido-izmēģinājumu nodalījums tiktu iekļauts testa iestatījumā; tad mēs aprēķinājām vidējo klasifikatora veiktspēju.
Tā kā stimulu ilgums dažādiem dalībniekiem bija atšķirīgs (180–320 ms kodēšanas stimuliem), tad, nosakot vidējo klasifikatora precizitāti starp dalībniekiem, mēs vispirms saskaņojām viņu datus katrā stimula sākumā, kas nozīmē, ka 3.–6. attēlā ir laika joslas (nokrāsotas). pelēkā krāsā), kur vidēji ir iekļauti 11 dalībnieki. Šajos attēlos x ass ir apzīmēta ar 320 ms stimulu.
Statistiskā pārbaude. Lai novērtētu, vai klasifikatora veiktspēja bija ievērojami augstāka par iespēju, mēs izmantojām permutācijas pārbaudes un sāknēšanas kombināciju, lai ģenerētu neparametriskus nulles sadalījumus.
Katram dalībniekam mēs paņēmām sākotnējos MEG izmēģinājuma datus, bet nejauši sajaucām izmēģinājuma etiķetes starp izmēģinājumiem dalībnieka datos. Izmantojot šos sajauktos iezīmju datus, mēs veicām tādas pašas klasifikācijas analīzes kā sākotnējiem datiem, tostarp pseidopārbaudes un 10-kārtīgu savstarpēju validāciju.
Mēs atkārtojām šo procesu 10 reizes, nejauši sajaucot izmēģinājuma etiķetes meklēšanas laiku, kā rezultātā tika iegūti 10 gadījuma koeficienta klasifikatora veiktspējas aprēķini katrai klasifikācijai katrā laikā. Tā kā šis process bija skaitļošanas ziņā ietilpīgs, mēs neatkārtojām visu šo procesu 10,000 reizes, bet tā vietā izmantojām sadalījuma Montekarlo aprēķinus (Efron un Tibshirani, 1994), nejauši atlasot šīs 10 aplēses (ar aizstāšanu). lai ģenerētu 10,000 aprēķinus par katru vidējo katra dalībnieka IA.
Mēs veicām šīs atkārtotās atlases procedūras atsevišķi katram pāru salīdzinājumam katrā laika paraugā, lai katrā gadījumā būtu dažādas sākotnējo 10 aplēšu kombinācijas. Tā rezultātā tika iegūts nulles sadalījums 10,{2}} datu kopu, ar kurām salīdzināt novērotā klasifikatora veiktspēju. Rezultātu attēlos attēlojiet centrālo 95% nulles vērtību diapazonu kā pelēku nokrāsu reģionu kopā ar rezultātiem, kuriem tie atbilst.
Katrā gadījumā mēs veicām visas nulles datu kopu analīzes tāpat kā sākotnējiem datiem (piem., ietverot vidējo dalībnieku skaitu) un pēc tam sakārtojām vērtības atsevišķi katram laika paraugam; no tiem mēs definējām centrālās 95% robežas kā 251. līdz 9750. vērtību.
Lai ģenerētu p vērtības, mēs salīdzinājām novēroto vērtību ar attiecīgo nulles sadalījumu. Piemēram, lai novērtētu, vai klasifikatora veiktspēja ir lielāka iespēja (vienpusējs tests), mēs definējām p-vērtību kā ekvivalento nulles vidējo vērtību proporciju, kas pārsniedz novēroto vidējo (Maris un Oostenveld, 2007).

Lai labotu vairākus salīdzinājumus starp laika joslām, mēs šīm p vērtībām izmantojām viltus atklāšanas ātruma (FDR) korekciju q, 0.05 (Benjamini un Hochberg, 1995). Papildus neparametriskiem testiem, kuru pamatā ir nulles sadalījums, mēs izmantojām aBayes faktora (BF) analīzi: alternatīvu tradicionālajai biežuma pieejai (Kass un Raftery, 1995; Morey un Wagenmakers, 2014), ko arvien vairāk izmanto MEG dekodēšanas pētījumos (Teichmannet). al., 2021).
BF salīdzina pierādījumus konkurējošām hipotēzēm; šeit mēs ziņojam, ja ir vidēji (BF .3) vai spēcīgi (BF .10) pierādījumi par labu alternatīvajai hipotēzei vai vismaz mēreni (BF, 1/3) pierādījumi par labu. nulles hipotēze. Mēs ieviesām visas BF analīzes, izmantojot MATLAB pakotni (Krekelberg, 2021).
Informācijas plūsmas analīze (IFA). No katras no 9 atrašanās vietām (36 pāri) un 8 attēliem (28 pāriem) pāru klasifikācijas katram no 5 stimuliem (4 kodēšanas stimuli un izguves stimuls) mums bija klasifikatora precizitāte laika gaitā (36 1 28) 5=320 klasifikācijas. 5 atšķirīgos laikmetos, kas atbilst laikam no katra stimula parādīšanas līdz nākamā stimula agrākajai parādīšanai (vai izguves stimula gadījumā līdz izmēģinājuma datu beigām), mēs izmantojām 64 klasifikatora precizitātes vērtības no jaunākā stimula. kā atšķirību matricu (DSM) katrā laika bin.
Mēs izmantojām šos DSM, lai pārbaudītu Grendžera cēloņsakarības starp katru ROI pāri (IFA; par šo un līdzīgām analīzēm sk. Ince et al., 2015; Goddard et al., 2016, 2022; Karimi-Rouzbahani, 2018; Kietzmann et al., 2019).
Tiek uzskatīts, ka IA A “Grendžera cēlonis” klasifikācijas veiktspējas modeli otrajā IA (B), ja pirmās IA pagātni var izmantot, lai prognozētu otrās IA turpmāko veiktspēju labāk nekā tikai otrā IA pagātni. veica Grendžera cēloņsakarības vienkāršota (īpaša gadījuma) slīdošā loga analīzi, izmantojot daļējās korelācijas (Spīrmena r) 2. vienādojumā, lai definētu informācijas plūsmu (IF) no ROI A uz ROI B (IFA.B) katrai laika joslai. (t).
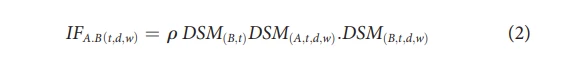
kur DSM(loc,t) ir DSM, pamatojoties uz avotiem ROI loc laikā t mspēc stimula sākuma, un DSM(loc,t,d,w) ir DSM, pamatojoties uz avotiem ROI loc, kas aprēķināts vidēji visās laika joslās no td ms līdz t-(d 1 w) ms pēc stimula sākuma. Mēs aprēķinājām FF un FB 30 logiem, kas pārklājas: 5 logu platumiem (w= 10, 20, 30, 40 vai 50 ms) katram no 6 aizkaves gadījumiem (d=50, 60, 70, 80). , 90 vai 100). Tāpat kā iepriekšējā darbā (Goddard et al., 2022), tā kā w un d vērtībām rezultāti bija gandrīz līdzīgi, IFA.B vērtības tika aprēķinātas vidēji visām w un d vērtībām.
Papildus ziņošanai par IFA.B un IFB.Katram ROI pārim, kā parādīts 3. vienādojumā, ziņojiet par starpību starp tiem, lai novērtētu laikus, kad informācijas plūsmā starp ROI A un ROI B dominē viens virziens pār otru.
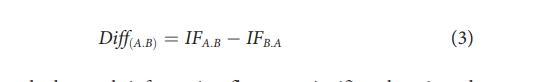
Lai novērtētu, vai katra informācijas plūsma bija nozīmīga .0 un vai katra atšķirība būtiski atšķiras no nulles, tika atkārtotas informācijas plūsmas analīzes katrā no 10,{2}} datu kopām, kas tika ģenerētas, sajaucot izmēģinājuma etiķetes (aprakstīts iepriekš). .
Katram ROI pārim tika izveidots nulles informācijas plūsmas (IF) un atšķirību (Diff) sadalījums, ar kuru salīdzināt novērotās vērtības. Mēs tos izmantojām, lai definētu centrālos 95% nulles sadalījuma, izmantojot analogu metodi, kas aprakstīta iepriekš klasifikatora veiktspējai. Līdzīgi mēs arī ieguvām p vērtības no šiem nulles sadalījumiem: IF gadījumā mēs jautājām, vai novērotā vērtība ir lielāka par nulli (vienpusējs tests, kā iepriekš); un attiecībā uz Diff mēs jautājām, vai novērotās atšķirības absolūtā vērtība bija lielāka amplitūdā nekā nulles sadalījuma absolūtā vērtība, definējot p-vērtību kā nulles vērtību proporciju ar lielāku absolūto vērtību nekā novērotā (divpusējs tests).
Tāpat kā iepriekš, šīm p vērtībām tika piemērota FDR korekcija q, 0.05, lai labotu vairākus salīdzinājumus laika punktos. Lai papildinātu šīs analīzes, mēs veicām BF analīzi kā novēroto efektu relatīvā stipruma indeksu.

For more information:1950477648nn@gmail.com